2주차 — Ollama와 Python으로 로컬 LLM 챗봇 만들기
Local LLM Study / 2주차
1주차에는 Ollama를 설치하고 로컬 GGUF 모델을 등록해 추론을 수행했다. 또한 CLI와 서버·Runner의 관계, Prefill·Decode, Context 길이에 따른 KV Cache 할당을 로그로 확인했다.
2주차에는 그 실행 환경을 Python 애플리케이션에서 사용했다. 먼저 기존 모델을 확인하고 uv로 프로젝트를 구성한 뒤, Ollama Python 라이브러리로 모델에 요청을 보내고 스트리밍과 대화 기록을 구현했다.
실습에서 나온 결과를 Ollama 서버 로그와 대조해 동작을 살펴봤다.
학습 목표
- Ollama CLI, HTTP API, Python 클라이언트의 역할을 구분한다.
uv프로젝트와 가상환경, 의존성 잠금 파일의 역할을 이해한다.- Python의
ollama.chat()으로 로컬 LLM을 호출한다. - 스트리밍 응답의 첫 텍스트 수신 시간과 전체 처리 시간을 측정한다.
- 대화 기록을 애플리케이션에서 유지하고 파일로 저장한다.
- 애플리케이션의 Conversation History와 추론 엔진의 Prompt Cache를 구분한다.
실습 환경
| 항목 | 확인한 정보 |
|---|---|
| 하드웨어 | MacBook Pro 14 · Apple M5 · Unified Memory 32GiB |
| 운영체제 | macOS |
| Ollama | 0.40.9 |
| 로컬 모델 | gemma3-local:latest · Gemma 3 4B |
| 모델 양자화 | GGUF Q4_0 · 모델 파일 약 2.35GiB |
| 모델 파라미터 | 약 3.88B |
| 실행 컨텍스트 | 32,768토큰 (모델 메타데이터는 131,072토큰) |
| 추론 설정 | Metal · Flash Attention 활성화 · KV Cache q8_0 |
| Python | 3.15.0 |
| 패키지 관리자 | uv |
| Ollama Python 패키지 | 0.6.3 |
이 글의 수치는 위 환경과 개별 요청에서 관찰한 값이다. 다른 하드웨어나 모델의 일반적인 성능을 뜻하지 않는다.
핵심 개념 — Ollama를 애플리케이션에서 사용하기
CLI, API, Python 라이브러리
ollama run은 사람이 터미널에서 모델과 대화하기 위한 인터페이스다. Python 코드로 기능을 자동화하려면 Ollama 서버의 HTTP API를 사용할 수 있다. 공식 ollama Python 패키지는 그 API를 호출하는 클라이언트 인터페이스를 제공한다.
전체 구조는 다음과 같다.
flowchart TD
    PY["Python 애플리케이션<br/>ollama.chat()"]
    LIB["Ollama Python 패키지<br/>HTTP 클라이언트"]
    API["Ollama Server<br/>127.0.0.1:11434 · /api/chat"]
    RUN["llama-server Runner<br/>GGUF 로딩 · 토큰 추론"]
    GPU["Apple M5 · Metal GPU"]
    PY --> LIB --> API --> RUN --> GPU
    GPU --> RUN --> API --> LIB --> PY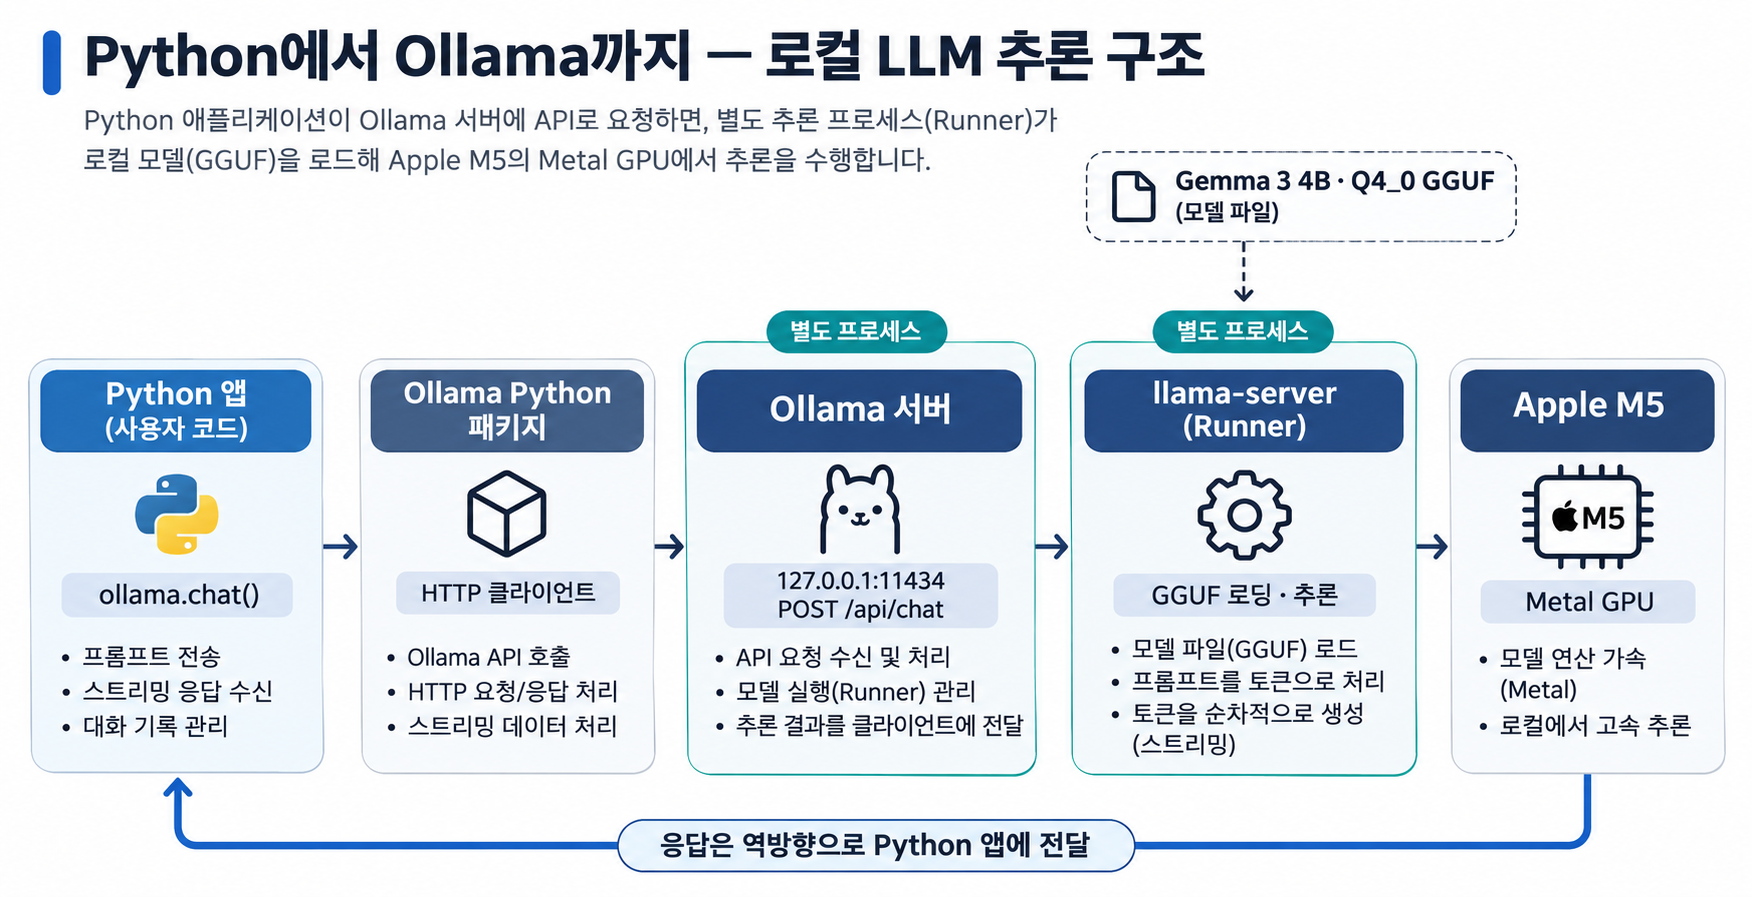
1주차에서 확인한 대로 Ollama 서버와 Runner는 별도의 생명주기를 가질 수 있다.
Python에서 chat()을 호출한다고 Python 프로세스가 직접 모델 가중치를 로딩해 추론하는 것은 아니다.
모델 크기와 메모리
4B는 약 40억 개의 파라미터를 의미한다. 이번 모델의 실제 메타데이터에는 약 3.88B가 기록됐다.
Q4_0은 모델 가중치의 양자화 형식이며, OLLAMA_KV_CACHE_TYPE=q8_0은 추론 중 사용하는 KV Cache의 저장 정밀도를 지정한다.
가중치 양자화와 KV Cache 양자화는 서로 다른 대상에 적용된다.
실습 1 — 기존 로컬 모델 확인
터미널 A에는 아래와 같이 서버를 실행했다.
별도의 터미널 B에서 모델 목록과 모델 정보를 확인했다.
실제 결과에서 발췌
ollama version is 0.40.9

NAME                    ID              SIZE
gemma3-local:latest     048ab3b6a24f    2.5 GB

architecture        gemma3
parameters          3.9B
context length      131072
embedding length    2560
quantization        Q4_0
ollama list의 SIZE는 등록된 모델 파일을 나타내는 값이며, 실행 중 메모리 점유량과 같지 않다.
ollama show의 context length도 모델 메타데이터의 지원 길이일 뿐, 매 요청에 실제 할당된 길이와 다를 수 있다.
Runner 로그에서 발췌
GPU name: Apple M5
file type = Q4_0
file size = 2.35 GiB
offloaded 35/35 layers to GPU
n_ctx = 32768
flash_attn = enabled
MTL0 KV buffer size = 340.00 MiB  # non-SWA
MTL0 KV buffer size = 123.25 MiB  # SWA
실제로 모델 레이어를 GPU에 오프로딩했고, 컨텍스트는 32,768토큰으로 생성됐다. Non-SWA와 SWA KV Cache가 별도로 할당된 점도 확인했다. 여기의 개별 버퍼 크기를 운영체제 전체 물리 메모리 점유량으로 해석하지는 않는다.
실습 2 — uv로 Python 개발 환경 구성
프로젝트 생성 및 의존성 추가
uv init --no-package local-llm-week2
cd local-llm-week2
uv add ollama
uv run python --version
uv tree
실행 결과, Python 3.15.0을 사용하는 가상환경이 생성되고 ollama==0.6.3 등 12개 패키지가 설치됐다.
Creating virtual environment at: .venv
Resolved 13 packages in 160ms
Installed 12 packages in 7ms
...
 + ollama==0.6.3
 + httpx==0.28.1
 + pydantic==2.14.2
...
Python 3.15.0
프로젝트 파일의 역할
| 파일 | 역할 |
|---|---|
pyproject.toml |
프로젝트 정보와 직접 의존성·Python 요구 버전 선언 |
.python-version |
프로젝트에서 기본으로 사용할 Python 버전 지정 |
.venv/ |
해당 프로젝트에 격리된 Python 실행 환경 및 설치 패키지 |
uv.lock |
의존성 해결 결과, 패키지 버전과 배포 정보의 잠금 파일 |
main.py |
uv init이 생성한 초기 코드 |
README.md |
프로젝트 설명 |
.gitignore |
Git 추적 제외 규칙 |
uv init 직후에는 .venv/와 uv.lock이 없었고, uv add ollama 이후 생성됐다.
프로젝트의 의존성이 필요해졌을 때 uv가 환경을 생성·동기화한 결과다.
실제 pyproject.toml에는 아래와 같이 기록됐다.
[project]
name = "local-llm-week2"
version = "0.1.0"
requires-python = ">=3.15"
dependencies = [
    "ollama>=0.6.3",
]
pyproject.toml은 필요한 패키지의 허용 범위를 선언하고, uv.lock은 해결한 구체적인 버전과 의존성을 기록한다.
따라서 다른 환경에서도 동일한 의존성 구성을 재현하는 데 도움이 된다. 다만 Python 버전과 OS별 호환성은 별도로 고려해야 한다.
왜 ollama만 추가했는데 여러 패키지가 설치됐을까?
실제로 uv tree는 다음 구조를 출력했다.
local-llm-week2 v0.1.0
└── ollama v0.6.3
    ├── httpx v0.28.1
    │   ├── anyio v4.15.1
    │   │   └── idna v3.20
    │   ├── certifi v2026.10.23
    │   ├── httpcore v1.0.9
    │   │   ├── certifi v2026.10.23
    │   │   └── h11 v0.16.0
    │   └── idna v3.20
    └── pydantic v2.14.2
        ├── annotated-types v0.8.0
        ├── pydantic-core v2.50.2
        │   └── typing-extensions v4.16.0
        ├── typing-extensions v4.16.0
        └── typing-inspection v0.4.4
            └── typing-extensions v4.16.0
ollama가 HTTP 통신용 httpx, 데이터 모델용 pydantic을 사용하고, 이들이 다시 다른 라이브러리에 의존하는 전이 의존성(Transitive Dependency) 때문이다.
uv tree는 이 관계를 확인하는 명령어다.
실습 3 — Python에서 모델 호출
chat.py는 다음과 같이 작성했다.
from ollama import chat

response = chat(
    model="gemma3-local",
    messages=[
        {
            "role": "user",
            "content": "Ollama가 무엇인지 설명해줘.",
        }
    ],
)

print(response.message.content)
로컬 모델이 Ollama의 역할과 특징을 한국어로 설명하는 응답을 반환했다.
서버 로그에는 POST "/api/chat"과 HTTP 200이 기록되어 Python 클라이언트 요청이 Ollama API를 통해 처리된 것을 확인했다.
같은 요청의 핵심 추론 로그
prompt eval time = 70.19 ms / 18 tokens
eval time        = 13087.37 ms / 544 tokens (41.49 tokens per second)
total time       = 13157.56 ms / 562 tokens
[GIN] ... | 200 | 13.67s | POST "/api/chat"
이번 요청에서는 생성된 응답이 544토큰으로 길었기 때문에 시간 대부분이 Decode에 사용됐다.
서버 내부의 추론 시간과 HTTP 요청 시간은 측정 범위가 다르다.
실습 4 — 스트리밍과 대화 기록
4-1. 스트리밍 응답과 소요 시간
비스트리밍 방식은 완성된 응답을 돌려주는 반면, 스트리밍 방식은 응답의 일부를 순서대로 받아 화면에 출력할 수 있다.
chat_stream.py에서 수행한 핵심 코드는 다음과 같다.
from time import perf_counter
from ollama import chat

messages = [{
    "role": "user",
    "content": "Python 가상환경이 무엇인지 5문장으로 설명해줘.",
}]

start = perf_counter()

stream = chat(
    model="gemma3-local",
    messages=messages,
    stream=True,
)

first_text_time = None
print("AI: ", end="", flush=True)

for chunk in stream:
    piece = chunk.message.content or ""
    if piece:
        if first_text_time is None:
            first_text_time = perf_counter()
        print(piece, end="", flush=True)

total_time = perf_counter() - start
print()

if first_text_time is not None:
    print(f"첫 텍스트 수신: {first_text_time - start:.2f}초")
print(f"전체 응답 시간: {total_time:.2f}초")
실제 측정 결과
Runner 로그에는 다음과 같이 기록됐다.
prompt eval time = 193.58 ms / 25 tokens
eval time        = 4685.27 ms / 193 tokens (40.98 tokens per second)
total time       = 4878.85 ms / 218 tokens
[GIN] ... | 200 | 5.39s | POST "/api/chat"
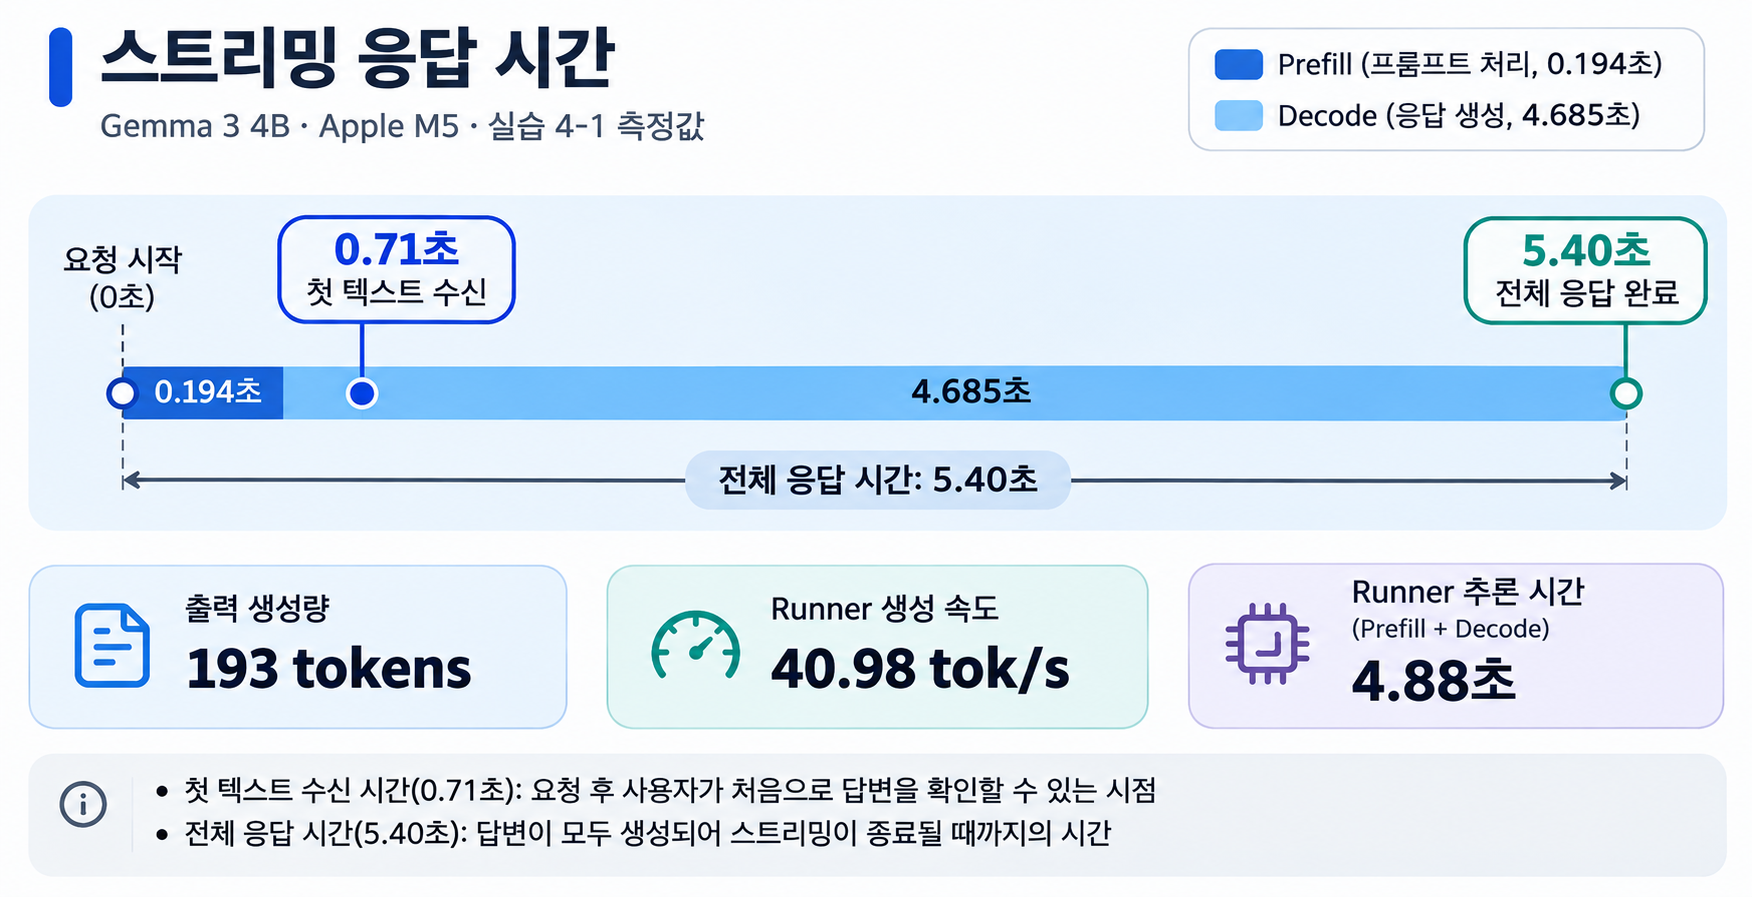
첫 텍스트는 0.71초 만에 수신했지만 전체 답변을 받는 데 5.40초가 걸렸다. 스트리밍으로 사용자가 결과를 읽기 시작하는 시점을 앞당길 수 있음을 확인했다.
단, 스트리밍 자체가 모델의 초당 토큰 생성 속도를 높인다는 의미는 아니다. 또한 Python이 첫 번째 텍스트 청크를 받은 시간과 모델 내부의 엄밀한 첫 토큰 생성 시간은 일치하지 않을 수 있다. 하나의 청크가 반드시 하나의 토큰인 것도 아니다.
4-2. 대화 기록을 유지하는 챗봇
chat_history.py에서는 history 리스트에 메시지를 순차적으로 저장하고, 매 요청마다 누적 기록을 ollama.chat(messages=history)로 전송했다.
from pathlib import Path
from ollama import chat

MODEL = "gemma3-local"
LOG_FILE = Path("chat_log.txt")
history = [{
    "role": "system",
    "content": (
        "You are a helpful AI assistant. "
        "Always respond in Korean."
    ),
}]

try:
    while True:
        try:
            user_input = input("\nYou: ").strip()
        except (EOFError, KeyboardInterrupt):
            print("\n대화를 종료합니다.")
            break

        if user_input.lower() in {"quit", "exit", "bye"}:
            break
        if not user_input:
            continue

        history.append({"role": "user", "content": user_input})

        try:
            stream = chat(
                model=MODEL,
                messages=history,
                stream=True,
            )
            print("\nAI: ", end="", flush=True)
            response_parts = []

            for chunk in stream:
                piece = chunk.message.content or ""
                print(piece, end="", flush=True)
                response_parts.append(piece)

            print()
            history.append({
                "role": "assistant",
                "content": "".join(response_parts),
            })
        except Exception as exc:
            history.pop()
            print(f"\n요청 실패: {exc}")
finally:
    with LOG_FILE.open("w", encoding="utf-8") as file:
        for message in history:
            file.write(
                f"[{message['role'].upper()}]\n"
                f"{message['content']}\n\n"
            )
    print(f"\n대화 기록 저장 완료: {LOG_FILE}")
실제 대화 결과
You: 안녕! 내 이름은 테스터야.
AI: 안녕하세요! ... 저는 ... AI 테스터입니다. ...

You: 내 이름이 뭐라고 했지?
AI: 제 이름은 테스터예요! 😊

You: 내 이름을 포함해서 한 문장으로 인사해줘.
AI: 안녕하세요, 저는 테스터입니다. 무엇을 도와드릴까요? 😊

You: bye
대화 기록 저장 완료: chat_log.txt
ls -lh chat_log.txt 결과 파일 크기는 552B였고, cat chat_log.txt에서 [SYSTEM], [USER], [ASSISTANT] 순서로 누적 기록이 저장된 것을 확인했다.
관찰한 한계: 모델이 테스터라는 문자열을 후속 답변에 사용하기는 했지만, 그 이름이 사용자에게 속한다는 사실을 정확히 반영하지 못하고 자기 이름처럼 말했다. 이는 대화 기록이 정상 전달되는 것과 모델이 화자·역할을 정확히 이해하는 것이 서로 다른 문제임을 보여준다. 이 사례만으로 코드에 대화 기록 오류가 있다고 판단할 수는 없다.
또한 현재 구현은 종료 시 파일을 "w" 모드로 덮어쓰고, 실행 시 파일을 불러오지는 않는다. 파일 저장과 세션 간 기억 복원은 다른 기능이다.
4-3. Conversation History와 Prompt Cache는 다르다
후속 대화 요청의 프롬프트는 다음과 같이 증가했다.
| 요청 | Runner의 전체 프롬프트 토큰 |
|---|---|
| 첫 번째 | 32 |
| 두 번째 | 85 |
| 세 번째 | 116 |
두 번째 요청에는 restored context checkpoint, cached n_tokens = 27이 나타났고, 세 번째 요청에도 restored context checkpoint, cached n_tokens = 80이 기록됐다.
# 두 번째 요청
restored context checkpoint (...)
cached n_tokens = 27

# 세 번째 요청
restored context checkpoint (...)
cached n_tokens = 80
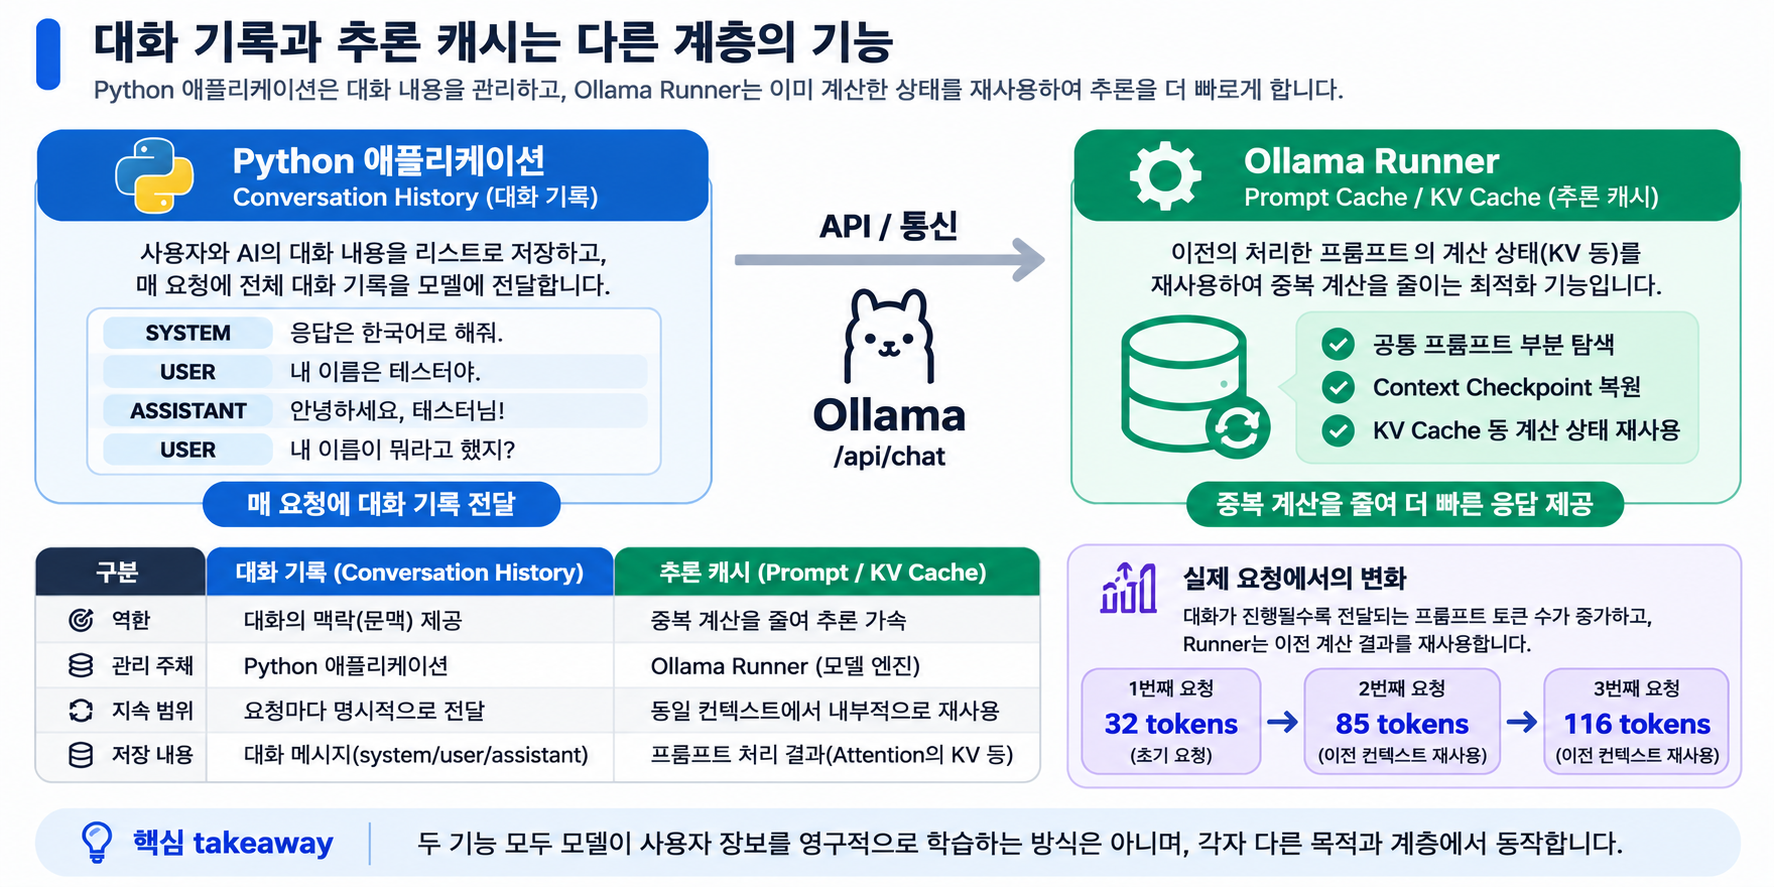
두 기능의 역할은 다음과 같이 다르다.
| 구분 | Conversation History | Prompt / KV Cache 재사용 |
|---|---|---|
| 관리 주체 | Python 애플리케이션 | Ollama / 추론 Runner |
| 저장 대상 | 사용자와 Assistant의 메시지 | 계산된 프롬프트 처리 상태·KV 등 |
| 목적 | 후속 요청에 과거 대화 제공 | 중복되는 프롬프트의 재계산 감소 |
| 영구 기억인가? | 현재 예제에서는 아님 | 아님 |
모델이 이전 대화를 참고하는 데 필요한 정보는 애플리케이션이 history로 제공한다. Runner는 반복되는 프롬프트의 공통 접두 부분에 대한 계산 상태를 재사용할 수 있다. 캐시 적중이 대화의 장기 기억을 만들어 주는 것은 아니다.
실습 로그의 prompt eval time과 cached n_tokens는 해당 Runner 구현의 측정 및 재사용 경로를 보여주지만, 캐시 효율을 일반화하려면 반복 측정과 조건 통제가 필요하다.
실습 결과
| 검증 항목 | 결과 |
|---|---|
| 모델 조회 및 로드 | 성공, gemma3-local 확인 |
| Python 프로젝트 환경 구성 | 성공, Python 3.15.0, ollama 0.6.3 |
| 의존성 확인 | 성공, uv tree에서 전이 의존성 확인 |
| Python → Ollama Chat API | HTTP 200, 실제 텍스트 응답 |
| 스트리밍 응답 | 성공, 첫 텍스트 0.71초 |
| 스트리밍 전체 응답 시간 | 5.40초 |
| 스트리밍 요청의 생성 속도 | 40.98 tokens/s (193 출력 토큰) |
| 대화 기록 누적 | 성공, 프롬프트 토큰 32 → 85 → 116 |
| 대화 기록 파일 저장 | 성공, chat_log.txt 552B |
| 사용자 이름 인식 | 이름 문자열을 활용했으나 사용자/AI 역할 혼동 |
정리 및 배운 점
- Ollama CLI와 Python 패키지는 로컬 Ollama 서버에 접근하는 서로 다른 인터페이스다. 모델 추론은 서버가 실행한 Runner에서 수행됐다.
uv는pyproject.toml,uv.lock,.venv를 통해 프로젝트 요구사항과 실행 환경을 관리한다.uv tree로 직접·전이 의존성을 확인했다.stream=True는 답변을 완성 전에 표시하는 데 유용했다. 이번 요청은 첫 텍스트 0.71초, 전체 5.40초였다.- 대화 기록은 애플리케이션이 관리하는 메시지 배열이다. 파일에 기록을 저장하는 것과 재시작 후 자동 복원하는 것은 별도 기능이다.
- Prompt Cache·KV Cache는 추론 계산의 재사용 수단이지, 모델이 사용자 정보를 영구적으로 학습한다는 뜻이 아니다.
- 모델이 과거 대화에 나온 문자열을 활용하더라도 화자와 맥락을 잘못 이해할 수 있다는 한계를 관찰했다.